
Arquitetura de informação é o desenho da estrutura que torna o conteúdo localizável e compreensível em qualquer produto digital. Aplica-se a sites, aplicações e intranets através de quatro sistemas interligados (organização, rotulagem, navegação e busca) e o resultado prático é sempre o mesmo: alguém encontra o que precisa sem esforço desnecessário e entende onde está.
Em resumo:
- Uma estrutura de informação bem desenhada melhora a encontrabilidade e compreensão do conteúdo, evitando que os utilizadores tenham dificuldades em localizar o que precisam.
- O projeto deve incluir etapas como inventário de conteúdo, card sorting, criação de taxonomia, sitemap, testes de usabilidade e ajustes contínuos.
- Testar a linguagem de rotulagem com utilizadores reais é essencial para garantir clareza e evitar ambiguidades na navegação.
- A arquitetura de informação deve estar integrada na estratégia de marca, pois influencia diretamente a perceção e confiança do utilizador.
- Ignorar a etapa de organização lógica resulta em websites que parecem bonitos, mas que ninguém consegue navegar com facilidade.
Índice
- O que é, afinal, arquitetura de informação?
- Quais são os elementos fundamentais da arquitetura de informação?
- Como estruturar um projecto de arquitetura de informação passo a passo
- Que princípios e boas práticas aplicar na arquitetura de informação?
- Que ferramentas e entregáveis usar em cada fase?
- Prova de autoridade: como a Cooprativa aborda a arquitetura de informação
- Como surgiu a arquitetura de informação e como evoluiu?
- Como se integra a arquitetura de informação com UX e design de interação?
- Qual é o impacto real da arquitetura de informação na experiência do utilizador?
- Quais são os desafios mais comuns e como superá-los?
- A perspectiva da Cooprativa sobre arquitetura de informação
- Fontes
O que é, afinal, arquitetura de informação?
A definição mais citada na disciplina descreve a arquitetura de informação como o desenho estrutural de ambientes de informação partilhada, incluindo organização, rotulagem, busca e navegação, tal como sistematizado na obra de referência de Rosenfeld e Morville. O termo nasceu ligado à biblioteconomia, disciplina que já organizava catálogos e taxonomias muito antes da internet existir, e migrou para o digital quando ficou claro que um site mal estruturado tinha os mesmos problemas de um arquivo sem índice.
Confunde-se frequentemente com UX, mas a diferença é de foco: a arquitetura de informação trata da estrutura e das relações entre conteúdos, enquanto a experiência do utilizador cobre toda a interação, incluindo emoção e usabilidade visual. O design de informação, por sua vez, ocupa-se da apresentação visual de dados, não da sua organização lógica.
Nem todo o projecto precisa de um exercício formal de arquitetura de informação. Uma landing page de uma única secção não exige taxonomia. Mas qualquer produto com mais de uma dezena de páginas, várias categorias de produto ou diferentes perfis de utilizador beneficia de decisões estruturadas antes de desenhar interfaces. Ignorar esta etapa é a razão mais comum para sites que “parecem bonitos mas ninguém encontra nada”.
Quais são os elementos fundamentais da arquitetura de informação?
Os quatro sistemas que sustentam qualquer estrutura de informação funcionam em conjunto, nunca isoladamente. Um sistema de organização define como o conteúdo é agrupado, seja por hierarquias (categorias e subcategorias) seja por facetas (atributos combináveis, como preço, cor e marca num catálogo de e-commerce). A escolha entre os dois modelos depende do volume de conteúdo e da diversidade de perfis de quem procura.
A rotulagem é onde mais projectos falham. Um rótulo tem de usar a linguagem que o utilizador reconhece, não a terminologia interna da empresa, e questões de semiótica e cognição ajudam a prever como diferentes públicos interpretam sinais e palavras. Chamar “Soluções” a uma secção de produtos é um erro clássico de rotulagem vago.
A navegação dá contexto: onde estou, de onde vim, para onde posso ir. E a busca interna depende inteiramente da qualidade dos metadados por trás do motor de indexação, já que sem estrutura de dados subjacente a busca devolve resultados irrelevantes por muito boa que seja a caixa de pesquisa.
Na prática, os quatro sistemas resolvem problemas distintos:
- Organização: agrupa conteúdo em categorias lógicas ou facetas combináveis.
- Rotulagem: nomeia secções e ligações com a linguagem do utilizador, não da empresa.
- Navegação: orienta o percurso e mostra a posição atual dentro da estrutura.
- Busca: recupera conteúdo com base em metadados bem estruturados, não apenas em palavras-chave soltas.
Como estruturar um projecto de arquitetura de informação passo a passo
Um projecto de arquitetura de informação segue uma sequência lógica, com entregáveis concretos em cada etapa. Este fluxo aplica-se tanto a um site institucional pequeno como a uma plataforma de e-commerce com milhares de referências, ajustando apenas a profundidade de cada etapa.
- Inventário de conteúdo. Cataloga-se tudo o que existe (páginas, documentos, produtos) e identificam-se duplicações, conteúdo desatualizado e lacunas óbvias.
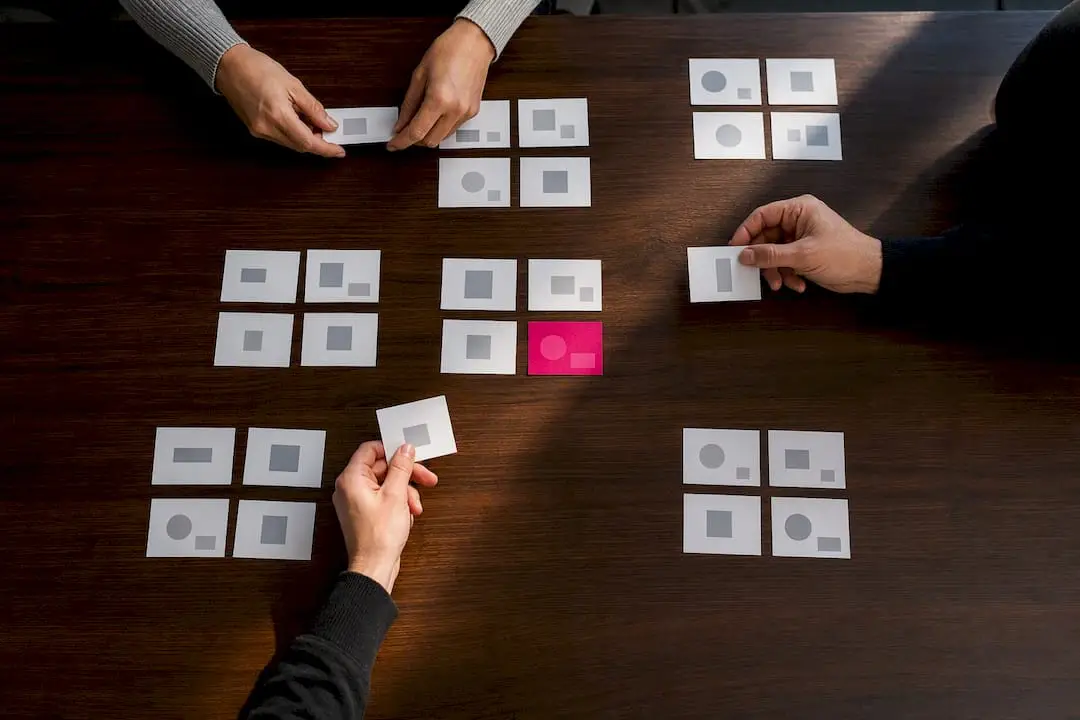
- Card sorting. Convidam-se utilizadores reais a agrupar cartões com nomes de conteúdos nas categorias que fazem sentido para eles, não para a equipa interna. Este método é uma das técnicas mais usadas para validar categorização antes de desenhar qualquer estrutura.
- Taxonomia e rotulagem. Com os padrões do card sorting, define-se a hierarquia final e escreve-se um guia de rotulagem com a terminologia aprovada.
- Sitemap e wireframes. O sitemap traduz a taxonomia em estrutura de páginas; os wireframes esboçam como a navegação se comporta em cada nível, sem ainda entrar em design visual.
- Tree testing e testes de usabilidade. O tree testing verifica se as pessoas conseguem localizar tarefas específicas dentro da estrutura proposta, sem interface visual a distrair o julgamento. Os testes de usabilidade, feitos já sobre wireframes ou protótipos, revelam problemas de navegação que estatísticas de acesso não mostram.
- Iteração e política de metadados. Ajusta-se a estrutura com base nos resultados e define-se uma política de metadados que assegure consistência entre quem publica conteúdo no futuro.
Dica profissional: Nunca saltes o card sorting para poupar tempo. É comum ver equipas a definir a taxonomia com base no organigrama da empresa, e isso quase sempre produz uma estrutura que só faz sentido para quem já lá trabalha.
Que princípios e boas práticas aplicar na arquitetura de informação?
Dan Brown sistematizou oito princípios que continuam a servir de referência prática, entre eles o Princípio dos Objetos (tratar conteúdos como entidades com ciclo de vida próprio), o Princípio das Escolhas (menos opções, mais claras) e o Princípio do Crescimento, que exige desenhar a estrutura já a pensar em expansão futura.
Uma checklist funcional para qualquer projecto:
- Testar a linguagem de rotulagem com representantes reais do público, porque a ambiguidade semântica raramente aparece em métricas de backend.
- Garantir acessibilidade nos rótulos e na navegação, incluindo compatibilidade com leitores de ecrã.
- Tratar a taxonomia como um sistema vivo, com revisão periódica e não como um documento fechado após o lançamento.
- Ligar a governança de rótulos aos processos de publicação, para que novos conteúdos não fujam à estrutura definida.
O erro mais comum é confundir arquitetura de informação com organograma interno da empresa. O
mais comum é tratá-la como tarefa pontual, quando exige manutenção contínua à medida que o conteúdo cresce.
Que ferramentas e entregáveis usar em cada fase?
A escolha de ferramentas depende da escala do projecto e do orçamento disponível, não existe um pacote único válido para todos os casos.
Para inventário e auditoria de conteúdo, folhas de cálculo continuam a ser suficientes em projectos pequenos; em estruturas maiores, ferramentas de gestão de conteúdo com etiquetagem automática poupam tempo. Para card sorting e tree testing, plataformas especializadas como o Optimal Workshop permitem correr testes remotos com dezenas de participantes e analisar padrões estatisticamente.
Os entregáveis padrão de qualquer projecto sério incluem:
- Sitemap navegável, normalmente em formato de diagrama hierárquico.
- Documento de taxonomia com definições e sinónimos aceites.
- Guia de rotulagem com termos aprovados e termos a evitar.
- Wireframes de baixa fidelidade para os principais tipos de página.
Ao escolher ferramentas, pesa-se sempre a curva de aprendizagem contra o número de stakeholders que precisam de aceder aos resultados. Um sitemap complexo em software especializado de nada serve se o cliente final não conseguir abri-lo.
Prova de autoridade: como a Cooprativa aborda a arquitetura de informação
Uma agência de comunicação já trabalhou com mais de 100 marcas nacionais e internacionais e acumulou mais de 150 prémios em comunicação e marketing digital, incluindo projectos de desenvolvimento web e UX/UI design. A metodologia combina criatividade e tecnologia numa abordagem disruptiva, tratando a estrutura de informação como parte inseparável da estratégia de marca, não como um detalhe técnico deixado para o fim do processo.
Isto significa que decisões de taxonomia e navegação são discutidas ao mesmo tempo que o posicionamento da marca, porque uma estrutura confusa pode comprometer a eficácia de qualquer campanha. A Cooprativa integra este raciocínio em projectos de branding, packaging e desenvolvimento de lojas online, onde a encontrabilidade decide directamente a taxa de conversão.
Como surgiu a arquitetura de informação e como evoluiu?
A expressão tem raízes na biblioteconomia, onde bibliotecários organizavam catálogos com sistemas de classificação muito antes da existência de qualquer interface digital. Esses princípios (categorização hierárquica, controlo de vocabulário, sistemas de indexação) foram a base conceptual sobre a qual a disciplina digital se construiu nos anos 1990, quando os primeiros sites deixaram de ser páginas isoladas e passaram a exigir estrutura de navegação.
A popularização do termo no contexto web ficou associada ao trabalho de Rosenfeld e Morville, cujo livro de referência transformou práticas dispersas num corpo coeso de métodos, incluindo card sorting e sitemaps. Nessa altura, a arquitetura de informação era sobretudo uma resposta a sites institucionais e portais de conteúdo com centenas de páginas.
A chegada dos dispositivos móveis obrigou a repensar hierarquias inteiras, porque uma estrutura pensada para ecrãs largos raramente funciona num ecrã pequeno com navegação por gestos. Mais recentemente, a disciplina passou a considerar que a estrutura de informação já não serve apenas leitores humanos: alimenta também algoritmos de recomendação e sistemas de inteligência artificial, que dependem de organização semântica clara para categorizar e sugerir conteúdo com precisão. Esta mudança está a redefinir como se pensa rotulagem e metadados hoje em dia.
Como se integra a arquitetura de informação com UX e design de interação?
A arquitetura de informação e o design de interação resolvem problemas diferentes mas dependentes um do outro. Um wireframe bem estruturado ainda pode falhar se as microinterações forem confusas, e uma interface visualmente impecável ainda pode confundir se a hierarquia por trás dela estiver errada.
Na prática, equipas de UX eficazes tratam a arquitetura de informação como a fase que antecede qualquer decisão visual. Só depois de a taxonomia e o sitemap estarem validados por tree testing é que faz sentido avançar para protótipos de alta fidelidade, porque mudar a estrutura depois do design visual estar fechado custa muito mais tempo e recursos do que ajustá-la em wireframes.
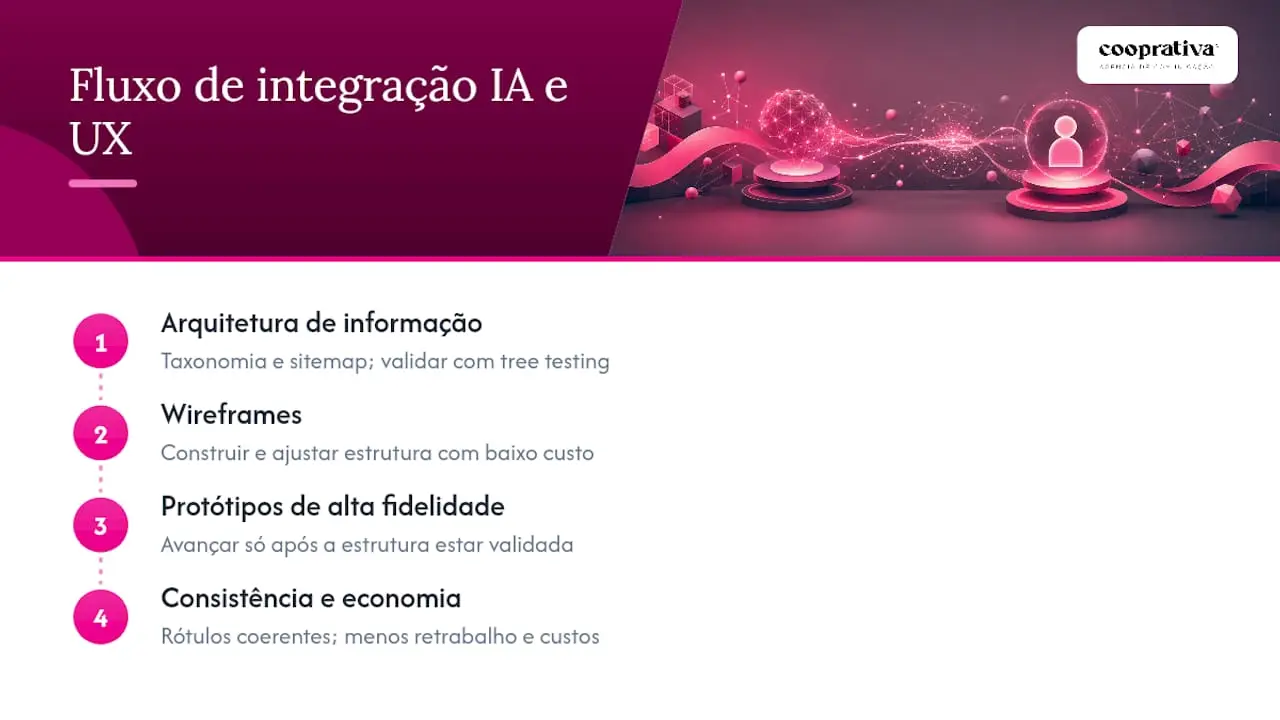
Esta integração também afeta como se define conteúdo, botões e chamadas para ação. Um rótulo de menu decidido na fase de arquitetura de informação tem de se manter coerente com o texto usado nos botões de interação, sob pena de o utilizador perder a noção de onde está. Equipas que separam completamente estas duas disciplinas, com arquitetos de informação e designers de interação a trabalhar sem comunicação, produzem sistematicamente produtos onde a estrutura lógica e a experiência visual parecem pertencer a dois projectos diferentes.
Qual é o impacto real da arquitetura de informação na experiência do utilizador?
Uma estrutura de informação mal desenhada é a causa mais frequente, e mais invisível, de abandono em sites e aplicações. O utilizador raramente sabe explicar porque não encontrou o que procurava, apenas sente frustração e sai. Esse é o efeito directo de sistemas de organização, rotulagem, navegação e busca que não foram pensados em conjunto.
O impacto mede-se em três dimensões concretas. A encontrabilidade determina se alguém chega à informação certa em poucos cliques. A compreensão determina se essa pessoa entende onde está e o que pode fazer a seguir. E a confiança, muitas vezes esquecida, depende de uma estrutura previsível: quando a navegação se comporta de forma consistente em todo o site, o utilizador confia mais na marca, mesmo sem conseguir verbalizar porquê.
Estudos de usabilidade mostram repetidamente que pequenas melhorias na rotulagem, sem qualquer mudança visual, aumentam significativamente a taxa de sucesso em tarefas concretas. Isto acontece porque a experiência do utilizador não começa no design da interface, começa na lógica que decide onde cada coisa está. Negligenciar a arquitetura de informação em favor de investimento visual é, na prática, gastar orçamento na camada errada do problema.
Quais são os desafios mais comuns e como superá-los?
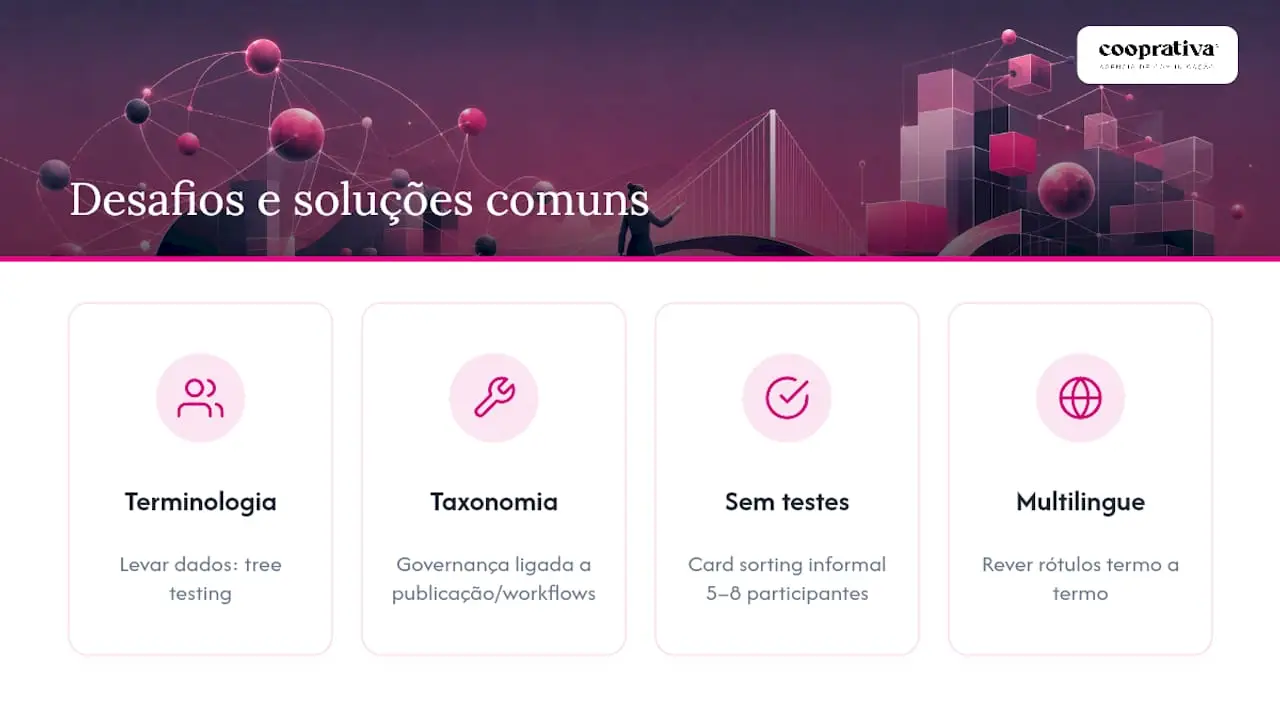
O desafio mais recorrente é a resistência interna à terminologia do utilizador. Equipas internas insistem em manter nomes de departamentos ou jargão de produto nos menus, porque é a linguagem que usam todos os dias, e resistem quando o card sorting mostra que os utilizadores pensam de forma completamente diferente. A solução passa por levar dados de teste, não opiniões, para essas discussões: números de tree testing convencem onde argumentos não convencem.
Outro obstáculo comum é o crescimento descontrolado da taxonomia. Cada nova campanha, produto ou departamento quer a sua própria categoria, e sem governança a estrutura fragmenta-se rapidamente. A governança de taxonomias precisa de estar ligada aos processos de publicação e a workflows editoriais, caso contrário cada equipa cria os seus próprios rótulos sem verificar o que já existe.
Há ainda o problema clássico de projectos sem orçamento para testes de validação, onde a estrutura é decidida apenas por intuição da equipa. Nestes casos, mesmo um card sorting informal com cinco a oito participantes revela padrões que a intuição sozinha não capta. Por fim, escalar a arquitetura de informação para múltiplos idiomas ou mercados exige rever rotulagem termo a termo, porque uma tradução literal raramente preserva o significado que funcionava na língua original.
A perspectiva da Cooprativa sobre arquitetura de informação
A maior parte dos guias sobre este tema trata a arquitetura de informação como um exercício técnico isolado, separado da estratégia de marca. Essa separação é o erro mais caro que uma equipa pode cometer. Uma estrutura de navegação mal rotulada não é apenas um problema de usabilidade, é uma falha de comunicação: a marca está literalmente a falar uma língua que o público não reconhece.
O que consideramos mais subestimado é o card sorting. Quase todos os projectos que analisamos ao longo dos anos saltam esta etapa por pressão de calendário, e é exactamente aí que aparecem as maiores surpresas sobre como as pessoas realmente pensam a categoria de um produto ou serviço. Testar estrutura antes de desenhar qualquer interface poupa retrabalho caro depois.
Se há uma prioridade a defender, é esta: trate a arquitetura de informação como parte do posicionamento de marca, não como tarefa técnica de retaguarda. A estrutura que o utilizador percorre é, ela própria, uma promessa sobre quem é a marca e como pensa.
— cooprativa
Fontes
Vamos pisar uva? 🍇
Utilize o formulário para entrar em contacto com a nossa equipa.

